SNT · Seconde · Contrôle Standard
Niveau 2 sur 3 · StandardDonnées — Structuration et traitement
Le niveau Standard est celui d'un contrôle de classe de SNT sur les données : vérifier un fichier CSV avant de calculer, enchaîner des requêtes sur une table de prêts d'ordinateurs, passer d'un fichier JSON imbriqué à une table plate, analyser un formulaire d'inscription au regard du RGPD, puis reconnaître les trois aspects du big data et interpréter une corrélation. Des questions guidées, sans banque de mots.
Imprimer le contrôle
Deux PDF à imprimer, sur papier A4. Gratuit, sans inscription.
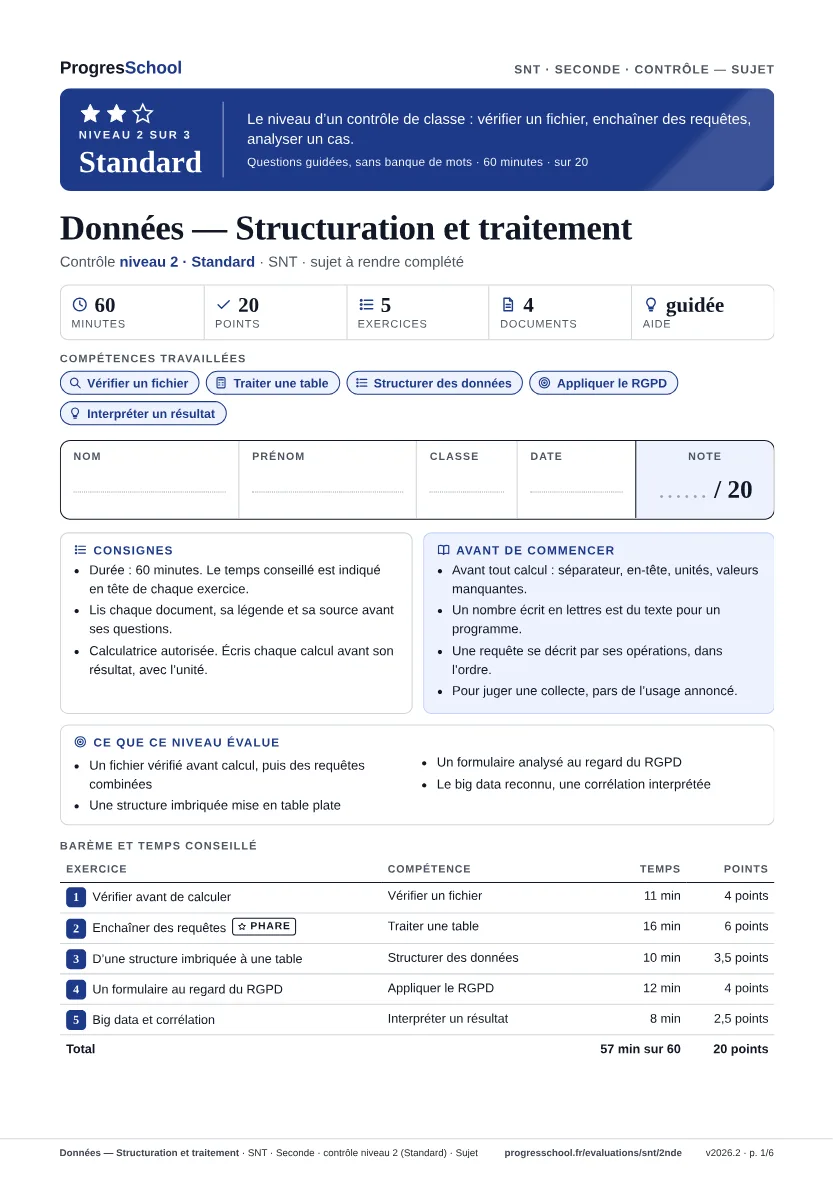
Ce que ce niveau évalue
- Vérifier un fichier
- Traiter une table
- Structurer des données
- Appliquer le RGPD
- Interpréter un résultat
- Un fichier vérifié avant calcul, puis des requêtes combinées
- Une structure imbriquée mise en table plate
- Un formulaire analysé au regard du RGPD
- Le big data reconnu, une corrélation interprétée
Avant de commencer
- Avant tout calcul : séparateur, en-tête, unités, valeurs manquantes.
- Un nombre écrit en lettres est du texte pour un programme.
- Une requête se décrit par ses opérations, dans l’ordre.
- Pour juger une collecte, pars de l’usage annoncé.
Exercice 1 — Vérifier avant de calculer
4 pts · 11 minVérifier un fichier
Lis le document 1 et sa légende, puis réponds aux questions.
- eleve;mode;duree
- E01;bus;25
- E02;vélo;12
- E03;marche;
- E04;bus;40
- E05;voiture;15
- E06;marche;vingt
- E07;bus;0,5
Fichier trajets.csv : la durée du trajet domicile-lycée déclarée par sept élèves. Aucune autre information n’accompagne le fichier. Source : Fichier fictif construit pour ce contrôle : les élèves et les valeurs sont inventés.
1.Quel caractère joue ici le rôle de séparateur ? Combien d’élèves ce fichier décrit-il ?
1 ptVoir la correction
Le point-virgule ; sept élèves, un par ligne, de la ligne 2 à la ligne 8.
Le séparateur s’identifie dès la première ligne ; la ligne 1 nomme les colonnes, elle n’est pas un enregistrement. 0,5 point par réponse.
2.Ligne 8, on lit « 0,5 ». Que peut signifier ce nombre, et que faudrait-il savoir pour trancher ?
1 ptVoir la correction
Probablement une demi-heure, quand les autres durées semblent données en minutes. Pour trancher, il faut savoir comment la durée a été demandée aux élèves : cette information doit accompagner le fichier.
Rien dans le fichier ne dit en quoi la durée s’exprime : seule une métadonnée, ou le producteur du fichier, peut trancher entre une demi-heure et une demi-minute.
3.Ligne 7, la durée est écrite « vingt ». Quel problème cela pose-t-il pour un programme, et comment le traiter ?
1 ptVoir la correction
C’est du texte et non un nombre : un programme ne peut ni l’additionner ni le trier avec les autres durées. On la remplace par 20 dans une copie du fichier, en gardant l’original intact.
Un nombre stocké comme texte fausse tout tri et tout calcul ; travailler sur une copie permet de revenir à la donnée d’origine. 0,5 pour le problème, 0,5 pour le traitement.
4.Ligne 4, la durée est vide. Calcule la durée moyenne sur les seules lignes 2, 3, 5 et 6, puis la valeur qu’on obtiendrait en comptant la case vide pour 0. Laquelle faut-il retenir ?
1 ptVoir la correction
25 + 12 + 40 + 15 = 92 ; 92 ÷ 4 = 23 min. En comptant la case vide pour 0 : 92 ÷ 5 = 18,4 min. Il faut retenir 23 min, calculée sur les valeurs connues.
Une case vide est une information non saisie, pas une durée nulle : la compter pour 0 fait baisser la moyenne sans raison. 0,5 pour les deux calculs, 0,5 pour le choix justifié.
Les erreurs fréquentes sur cet exercice
- Compter huit enregistrements en incluant la ligne d’en-tête.
- Corriger « vingt » ou « 0,5 » sans dire que le choix suppose une information que le fichier ne donne pas.
- Diviser par 5 en comptant la case vide comme une durée nulle.
Exercice 2 — Enchaîner des requêtes
6 pts · 16 minTraiter une table
Lis le document 2. Pour chaque question, écris les opérations utilisées dans l’ordre, puis le résultat.
- pret;classe;jour;duree_h;motif
- P01;2nde A;lundi;1,5;recherche
- P02;1re B;lundi;1;exposé
- P03;2nde C;mardi;2;exposé
- P04;2nde A;mardi;0,5;recherche
- P05;Tle D;mardi;1,5;recherche
- P06;2nde B;jeudi;1;exposé
- P07;1re B;jeudi;0,5;recherche
- P08;2nde C;jeudi;2;recherche
- P09;2nde A;vendredi;0,5;exposé
- P10;Tle D;vendredi;1;exposé
Fichier prets.csv : les prêts d’ordinateurs portables du CDI pendant une semaine. La colonne duree_h donne la durée du prêt, en heures. Source : Fichier fictif construit pour ce contrôle : les prêts et les durées sont inventés.
1.Combien de prêts concernent une classe de seconde ?
1 ptVoir la correction
Filtrer sur « classe commence par 2nde », puis calculer l’effectif : 6 prêts (P01, P03, P04, P06, P08, P09).
Un filtre suivi d’un comptage : on garde les enregistrements qui vérifient la condition, puis on les compte. 0,5 pour les opérations, 0,5 pour le résultat.
2.Quels prêts ont eu lieu le mardi, du plus long au plus court ?
1 ptVoir la correction
Filtrer sur « jour = mardi », puis trier par duree_h décroissante : P03 (2 h), P05 (1,5 h), P04 (0,5 h).
Le filtre réduit la table à trois enregistrements, le tri les ordonne sans en retirer aucun.
3.Pour la question précédente, Léo trie d’abord les dix prêts par durée, puis ne garde que ceux du mardi ; Sarah filtre d’abord, puis trie. Obtiennent-ils le même résultat ? Quelle démarche coûte le moins ?
1 ptVoir la correction
Le même résultat : P03, P05, P04. La démarche de Sarah coûte moins, car elle ne trie que trois lignes au lieu de dix.
L’ordre des opérations change le coût du traitement, jamais le résultat : filtrer d’abord réduit ce qu’il reste à trier.
4.Regroupe les prêts par motif et calcule la durée moyenne d’un prêt pour chaque motif.
1.5 ptVoir la correction
Regrouper par motif, puis calculer la moyenne dans chaque groupe. Exposé : 1 + 2 + 1 + 0,5 + 1 = 5,5 ; 5,5 ÷ 5 = 1,1 h. Recherche : 1,5 + 0,5 + 1,5 + 0,5 + 2 = 6 ; 6 ÷ 5 = 1,2 h.
Chaque groupe compte cinq prêts : on divise la somme de chaque groupe par 5, pas par 10. 0,5 pour le regroupement, 0,5 par moyenne juste.
5.Une élève conclut : « Les élèves de seconde se servent bien plus des ordinateurs que ceux de terminale. » Ce fichier permet-il de l’affirmer ? Justifie.
1.5 ptVoir la correction
Non. Le fichier compte des prêts d’une seule semaine, dans un seul CDI : il mesure la durée des prêts, pas le temps réel d’utilisation ni les ordinateurs utilisés ailleurs. Il ne dit pas non plus combien d’élèves compte chaque niveau.
C’est la dernière étape de la méthode : conclure sur ce que les données mesurent, et sur ce qu’elles ne mesurent pas. 0,5 par limite pertinente, dans la limite de 1,5.
Les erreurs fréquentes sur cet exercice
- Donner le résultat sans nommer les opérations qui y conduisent.
- Calculer la moyenne d’un motif en divisant par 10, le nombre total de prêts.
- Conclure sur l’usage des ordinateurs alors que le fichier ne mesure que des prêts.
Exercice 3 — D'une structure imbriquée à une table
3.5 pts · 10 minStructurer des données
Lis le document 3, puis réponds aux questions.
- {
- "sortie": "musée des sciences",
- "date": "14/05",
- "classe": "2nde B",
- "accompagnateurs": ["M. Bernard", "Mme Diallo"],
- "eleves": [
- {"prenom": "Lou", "repas": "pique-nique"},
- {"prenom": "Sami", "repas": "cantine"},
- {"prenom": "Zoé", "repas": "pique-nique"}
- ]
- }
Les retraits de ligne ne font pas partie des données : ils rendent la structure lisible. Source : Fichier fictif construit pour ce contrôle ; les noms sont inventés.
1.Relève dans le document 3 un couple nom-valeur simple, puis un champ dont la valeur est une liste.
1 ptVoir la correction
Par exemple « classe » : « 2nde B » ; le champ « accompagnateurs » (ou « eleves ») contient une liste.
Un couple simple associe un nom à une seule valeur ; les crochets signalent une liste. 0,5 point par élément.
2.Pourquoi ces données ne tiennent-elles pas telles quelles en une seule ligne de CSV ?
1 ptVoir la correction
Parce que le champ « eleves » contient une liste d’objets, de longueur variable, chacun avec ses propres champs : la structure est imbriquée, alors qu’une ligne de CSV ne range qu’une valeur par case.
Le CSV convient aux tables plates, le JSON aux données arborescentes : une liste d’objets ne s’aplatit pas sans choisir une autre organisation.
3.Écris un fichier CSV qui décrit les élèves de cette sortie : une ligne d’en-tête, puis une ligne par élève.
1.5 ptVoir la correction
prenom;repas;classe — Lou;pique-nique;2nde B — Sami;cantine;2nde B — Zoé;pique-nique;2nde B (quatre lignes ; on peut aussi répéter la sortie et la date sur chaque ligne).
On choisit qu’un enregistrement représente un élève ; ce qui est commun à tous, comme la classe, se répète sur chaque ligne. 0,5 pour l’en-tête, 0,5 pour les trois lignes, 0,5 pour un séparateur unique.
Les erreurs fréquentes sur cet exercice
- Écrire toute la liste des élèves dans une seule case du CSV.
- Oublier la ligne d’en-tête, ou changer de séparateur d’une ligne à l’autre.
Exercice 4 — Un formulaire au regard du RGPD
4 pts · 12 minAppliquer le RGPD
Lis le document 4, puis réponds aux questions en citant les lignes utiles.
- Inscription à l’application de covoiturage du lycée
- Usage annoncé : mettre en relation des élèves qui font le même trajet.
- Champs obligatoires : nom, prénom, classe, commune de départ,
- numéro de téléphone, date de naissance, photographie,
- religion, liste des sites web consultés dans le mois.
- « Vos données sont conservées sans limite de durée. »
- « En vous inscrivant, vous acceptez tout usage futur de vos données. »
Source : Formulaire fictif rédigé pour ce contrôle d’après le cours ; l’application n’existe pas.
1.Parmi les champs des lignes 3 à 5, lesquels permettent, à eux seuls, de retrouver qui s’est inscrit ? Cites-en deux, en justifiant.
1 ptVoir la correction
Par exemple la photographie et le numéro de téléphone : sans le nom, chacun suffit à reconnaître ou à joindre l’inscrit, qui reste identifiable.
Une donnée est personnelle dès que la personne est identifiable, directement ou par recoupement ; le nom n’est qu’un cas parmi d’autres. 0,5 par champ justifié.
2.Au regard de l’usage annoncé (ligne 2), quels champs sont de trop ? Quel principe le formulaire méconnaît-il ?
1 ptVoir la correction
La religion et la liste des sites consultés n’ont aucun rapport avec un trajet partagé (la date de naissance est discutable). Le formulaire méconnaît la minimisation.
La minimisation impose de ne collecter que ce qui est nécessaire à l’usage annoncé : pour mettre en relation des élèves sur un trajet, la commune et un moyen de contact suffisent.
3.La ligne 6, puis la ligne 7 : quelle règle du RGPD chacune enfreint-elle ?
1 ptVoir la correction
Ligne 6 : on ne garde les données que le temps de l’usage, jamais indéfiniment. Ligne 7 : aucun usage précis n’est annoncé, ce qui viole la finalité ; accepter un usage inconnu, ce n’est pas accepter en connaissance de cause.
La conservation a une fin, et un accord ne vaut que pour un usage annoncé à l’avance. 0,5 par ligne.
4.Un élève quitte le lycée et veut que l’application supprime ses données ; une autre refuse que son numéro serve à lui envoyer de la publicité. Quel droit chacun exerce-t-il ?
1 ptVoir la correction
Le premier exerce son droit à l’effacement ; la seconde, son droit d’opposition.
L’effacement fait supprimer les données ; l’opposition permet de refuser un usage particulier, ici la publicité. 0,5 par droit.
Les erreurs fréquentes sur cet exercice
- Ne voir de donnée personnelle que dans le nom et le prénom.
- Citer un principe sans montrer, ligne à l’appui, en quoi le formulaire le méconnaît.
Exercice 5 — Big data et corrélation
2.5 pts · 8 minInterpréter un résultat
Une ville équipe ses rues de capteurs. Chacun envoie une mesure chaque seconde ; s’y ajoutent les images des caméras de circulation et les messages laissés par les habitants. Chaque jour, des milliards de valeurs arrivent. Réponds aux questions.
1.Associe chacun des trois aspects du big data à un élément de la situation : le volume, la vitesse, la variété.
1.5 ptVoir la correction
Volume : des milliards de valeurs par jour. Vitesse : une mesure chaque seconde. Variété : des nombres, des images et des messages écrits.
Les trois aspects ne se confondent pas : la quantité totale, le rythme d’arrivée, la diversité des natures de données. 0,5 par association juste.
2.Sans hypothèse de départ, les analystes constatent que les jours où l’on vend le plus de parapluies, les bus ont le plus de retard. Peut-on dire que les parapluies retardent les bus ? Propose une autre explication.
1 ptVoir la correction
Non : c’est une corrélation, pas une cause. Une autre explication : la pluie fait à la fois vendre des parapluies et ralentir la circulation.
Deux grandeurs peuvent varier ensemble parce qu’une même cause agit sur les deux ; une corrélation trouvée sans hypothèse doit être expliquée, pas prise pour une cause. 0,5 pour le refus, 0,5 pour l’explication.
Les erreurs fréquentes sur cet exercice
- Attribuer la mesure envoyée chaque seconde au volume plutôt qu’à la vitesse.
- Admettre que les parapluies retardent les bus parce que les deux varient ensemble.
Barème — ce que le correcteur regarde
Les lignes chiffrées couvrent les 5 exercices et totalisent 20 points.
Ex.1Le fichier vérifié avant tout calcul
4 points — 1 par question
Point perdu si : Une moyenne qui compte la case vide pour zéro : 0,5 sur 1.
Ex.2Les requêtes enchaînées, opérations nommées
6 points — 1 + 1 + 1 + 1,5 + 1,5
Point perdu si : Un résultat juste sans les opérations qui y conduisent : la moitié des points de la question.
Ex.3La structure imbriquée mise en table
3,5 points — 1 + 1 + 1,5
Point perdu si : Une liste écrite dans une seule case du CSV.
Ex.4Le formulaire analysé, lignes à l’appui
4 points — 1 par question
Point perdu si : Un principe nommé sans la ligne qui le méconnaît : 0,5 sur 1.
Ex.5Le big data reconnu, la corrélation interprétée
2,5 points — 1,5 + 1
Point perdu si : La corrélation prise pour une cause : 0 sur 1.
Et maintenant ?
- 16 à 20Niveau supérieur
- C'est le niveau attendu en classe, et tu l'as. Passe au niveau 3 — Approfondi : un croisement de fichiers à réaliser, une copie à corriger, une structure à concevoir et une décision à argumenter.
- 10 à 15Refaire ce niveau
- Repère l'exercice où tu as perdu le plus de points et relis son rappel de cours. Refais le niveau 2 dans quelques jours ; vise 16 avant de passer au niveau 3.
- moins de 10Niveau inférieur
- Fais d'abord le niveau 1 — Essentiel : il vérifie le vocabulaire des fichiers et les opérations élémentaires dont ce contrôle a besoin. Reviens ensuite au niveau 2.
Les autres contrôles de ce chapitre
Aucun ne repose une question d'un autre : chacun couvre le chapitre sous un autre angle. À passer quelques jours plus tard, une fois celui-ci corrigé.
Les autres contrôles de snt Seconde
Programme de seconde générale et technologique — BO spécial n°1 du 22 janvier 2019 · Contrôle rédigé pour ProgresSchool, version 2026.2.